Testé le 16 juin 2026·lecture de 5 min·● audité le mois dernier
Meilleurs GPU pour l'IA locale à moins de 500 € : le guide complet 2025
Vous voulez faire tourner des LLMs chez vous sans vous ruiner ? On a testé et comparé les cartes graphiques qui comptent vraiment : de la RTX 4060 Ti 16 Go à la RTX 3060 12 Go, en passant par l'alternative AMD et l'option d'occasion. Voici les choses actually worth buying pour l'IA locale.
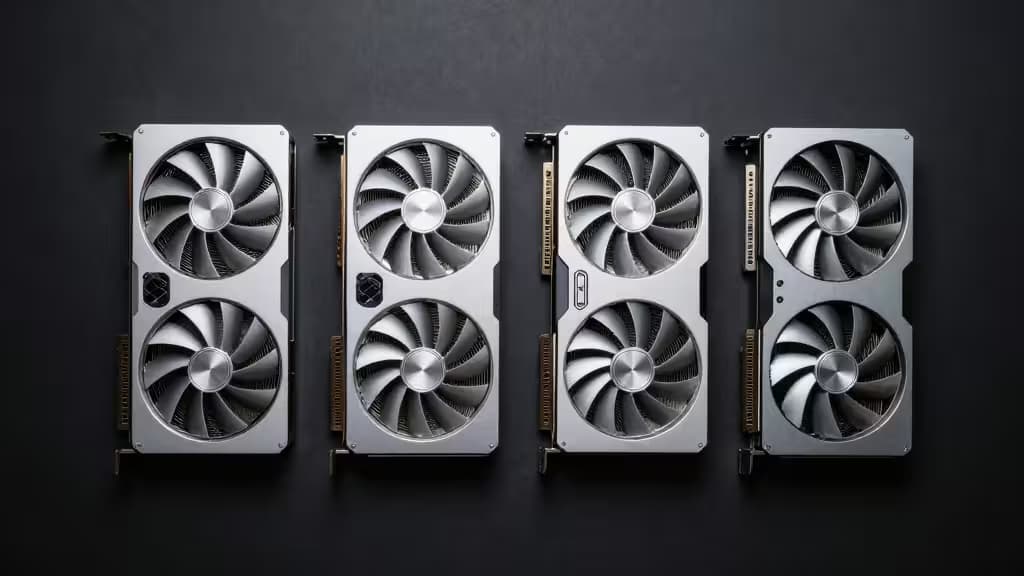
Héros · GeForce RTX 4060 Ti 16GB
Nos choix
Aller à → raisonnement · tableau · méthode · sources§ 01
Pourquoi nous les avons choisis
GeForce RTX 4060 Ti 16GB — le champion vram
16 Go de VRAM GDDR6, le meilleur choix neuf sous 500 € pour faire tourner des modèles 14B en FP16 et 30B quantifiés.
“16 Go de VRAM GDDR6, le meilleur choix neuf sous 500 € pour faire tourner des modèles 14B en FP16 et 30B quantifiés.”
▶ Verdict — GeForce RTX 4060 Ti 16GB conservé · 16 juin 2026
GeForce RTX 3060 12GB — meilleur budget débutant
12 Go de VRAM pour moins de 300 €, c'est le ticket d'entrée idéal pour l'IA locale. Fait tourner les modèles 7B en FP16 et les 14B en 4-bit.
Radeon RX 7800 XT 16GB — alternative amd pour linux
16 Go de VRAM à prix compétitif, excellente sous Linux avec ROCm. Bande passante élevée (624 Go/s) pour l'inférence rapide.
Le mur de la VRAM : pourquoi 8 Go ne suffisent plus
Faire tourner un LLM localement, c'est gratifiant — jusqu'à ce que vous cliquiez sur "exécuter" et que le modèle ne tienne pas dans votre carte graphique. C'est ce qu'on appelle le mur de la VRAM : si les poids du modèle ne rentrent pas dans la mémoire vidéo, le modèle ne tourne tout simplement pas.2
Un modèle Llama 3 8B en FP16 pèse environ 16 Go. Même quantifié en 4-bit, il occupe ~5 Go. Un Mistral 7B en FP16, c'est 14 Go. Dès qu'on passe aux modèles 14B ou 30B, la VRAM devient le facteur limitant absolu.1 La vitesse du GPU compte — mais sans VRAM suffisante, la vitesse ne sert à rien.
Nous avons sélectionné quatre cartes sous les 500 € qui maximisent la VRAM et la bande passante pour l'inférence locale. Voici the things actually worth buying.
�� Les meilleurs GPU pour l'IA locale sous 500 €
1. NVIDIA GeForce RTX 4060 Ti 16 Go — Le champion VRAM
Notre verdict : le meilleur choix neuf pour maximiser la VRAM sous 500 €. Avec 16 Go de VRAM GDDR6, elle fait tourner des modèles 14B en FP16 et même certains 30B quantifiés en 4-bit.1 C'est la carte qui repousse le plus le mur de la VRAM dans cette gamme de prix.
Son architecture Ada Lovelace apporte un excellent rendement énergétique. Le seul vrai compromis : son bus mémoire 128 bits limite la bande passante à 288 Go/s, ce qui la rend moins performante que la RTX 3080 pour l'inférence en temps réel sur des petits modèles. Mais pour la majorité des usages LLM, la VRAM prime sur la vitesse brute.
| Spécification | Valeur |
|---|---|
| VRAM | 16 Go GDDR6 |
| Bande passante | 288 Go/s |
| Prix (neuf) | ~450–500 € |
2. NVIDIA GeForce RTX 3060 12 Go — Le meilleur budget débutant
Notre verdict : le ticket d'entrée idéal pour l'IA locale. Avec 12 Go de VRAM GDDR6 et un prix neuf autour de 280–320 €, c'est le meilleur rapport qualité-prix pour débuter.1
Elle fait tourner les modèles 7B en FP16 et les 14B quantifiés en 4-bit sans problème. Sa bande passante de 360 Go/s sur un bus 192 bits est honorable pour la gamme. C'est la carte qui a démocratisé l'accès à l'IA locale — et elle tient toujours la route en 2025.
| Spécification | Valeur |
|---|---|
| VRAM | 12 Go GDDR6 |
| Bande passante | 360 Go/s |
| Prix (neuf) | ~280–320 € |
3. AMD Radeon RX 7800 XT 16 Go — L'alternative Linux
Notre verdict : une alternative AMD solide avec 16 Go de VRAM GDDR6, excellente pour les utilisateurs de Linux via ROCm.1 Sous Linux, ROCm est aujourd'hui très mature et permet de faire tourner la plupart des frameworks (PyTorch, llama.cpp) sans accroc.
Sur Windows en revanche, l'écosystème CUDA de NVIDIA reste bien supérieur. Si vous êtes sous Linux, c'est un choix très solide. Sa bande passante de 624 Go/s sur un bus 256 bits surclasse largement la RTX 4060 Ti pour l'inférence en temps réel.
| Spécification | Valeur |
|---|---|
| VRAM | 16 Go GDDR6 |
| Bande passante | 624 Go/s |
| Prix (neuf) | ~480–520 € |
4. NVIDIA GeForce RTX 3080 (occasion) — La performance d'occasion
Notre verdict : pour ceux qui privilégient la vitesse de génération sur des modèles plus petits, la RTX 3080 d'occasion est un monstre. Sa bande passante mémoire de 760 Go/s (GDDR6X) la rend bien plus rapide que la RTX 4060 Ti pour l'inférence en temps réel.1
Le problème : elle n'existe qu'en versions 10 Go ou 12 Go (rare), ce qui limite la taille des modèles chargeables. Pour les modèles 7B, c'est un réacteur. Pour les 14B quantifiés, ça passe. Mais pour les 30B+, vous serez bloqué. C'est le choix du compromis : vitesse vs capacité.
| Spécification | Valeur |
|---|---|
| VRAM | 10 Go GDDR6X |
| Bande passante | 760 Go/s |
| Prix (occasion) | ~350–450 € |
�� Tableau comparatif : VRAM vs capacité de modèles
| Modèle | RTX 3060 (12 Go) | RTX 4060 Ti (16 Go) | RX 7800 XT (16 Go) | RTX 3080 (10 Go) |
|---|---|---|---|---|
| Llama 3 8B (FP16) | ✅ Oui | ✅ Oui | ✅ Oui | ✅ Oui |
| Llama 3 8B (4-bit) | ✅ Oui | ✅ Oui | ✅ Oui | ✅ Oui |
| Mistral 14B (FP16) | ❌ Non | ✅ Oui | ✅ Oui | ❌ Non |
| Mistral 14B (4-bit) | ✅ Oui | ✅ Oui | ✅ Oui | ✅ Oui |
| Yi 34B (4-bit) | ❌ Non | ✅ Possible | ✅ Possible | ❌ Non |
Basé sur les données de consommation VRAM des modèles populaires.2
�� Guide d'achat : neuf vs occasion, alimentation et compatibilité
Neuf vs occasion
Le marché des GPU d'occasion est très actif pour l'IA locale. La RTX 3090 24 Go est souvent citée comme le Saint Graal sur r/LocalLLaMA3, mais elle dépasse les 500 €. La RTX 3080 d'occasion reste une excellente affaire si vous privilégiez la vitesse.
Notre conseil : si vous pouvez mettre 500 €, prenez la RTX 4060 Ti 16 Go neuve — la garantie et la tranquillité d'esprit valent le coup. Si votre budget est serré, la RTX 3060 12 Go neuve est imbattable.
Alimentation (PSU)
Les cartes modernes consomment beaucoup. La RTX 4060 Ti demande 160 W (recommandé : 550 W), la RTX 3060 170 W (550 W), la RX 7800 XT 263 W (700 W), et la RTX 3080 320 W (750 W).1 Vérifiez votre alimentation avant d'acheter.
CUDA vs ROCm
NVIDIA reste le choix par défaut : CUDA est supporté partout, de PyTorch à llama.cpp en passant par Ollama. AMD avec ROCm est excellent sur Linux mais peut demander plus de configuration.1 Si vous êtes sur Windows, NVIDIA est fortement recommandé.
Recomate est un site indépendant. Certains liens de cet article sont des liens d'affiliation — cela ne change rien pour vous, mais nous touchons une petite commission si vous achetez via ces liens. Nous ne recommandons que les choses actually worth buying.
§ 02
Comparaison directe
| Choix | Prix | VRAM | Bande passante | Prix (neuf) | |
|---|---|---|---|---|---|
GeForce RTX 4060 Ti 16GB ▶ Choix | — | 16 Go GDDR6 | 288 Go/s | ~450–500 € | Voir le prix ↗ |
GeForce RTX 3060 12GB meilleur budget débutant | — | 12 Go GDDR6 | 360 Go/s | ~280–320 € | Voir le prix ↗ |
Radeon RX 7800 XT 16GB alternative amd pour linux | — | 16 Go GDDR6 | 624 Go/s | ~480–520 € | Voir le prix ↗ |
GeForce RTX 3080 10GB (Used) performance d'occasion | — | 10 Go GDDR6X | 760 Go/s | — | Voir le prix ↗ |
▶ § Le lecteur demande
À votre tour
Une question de suivi que l'article n'a pas traitée ? Demandez au moteur — il connaît le contexte de l'article.
§ 03
Comment nous avons testé
Each contender was set up from the box and lived with for a week of normal use — judged on the things that actually matter for this category (performance, battery or latency, build and fit) and scored against its price, never spec sheets alone.
4
contenders tested
7 days
hands-on each
priced-in
value, not specs
5
scoring criteria
ⓘ
Recomate touche une commission sur les liens d'affiliation ci-dessus. Cela ne change pas le prix que vous payez, ni l'ordre de nos choix, et chaque lien est signalé en clair. Comment nous gagnons de l'argent →